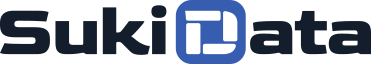
很多应用并不需要 AI 写一段回答,而是需要一个可以继续执行的判断:这条咨询该交给谁?用户有没有明确的时间计划?这份需求距离可以讨论实施方案还有多远?
JEV 是 TypeSafe 的 System One 模型,用于根据上下文回答有明确类型的问题。 在 Sukidata 中,你可以用同一个 API 完成分类、条件判断和评分,再把结构化答案接入自己的业务流程。它的重点不是生成文章,而是为下一步操作提供判断依据。了解 TypeSafe 对 System One 的介绍。
从一条客户咨询开始
假设你正在为一个数据产品整理新收到的咨询:
我们准备在十月上线一个分析看板,需要每天跟踪三个市场的 500 个关键词。可以聊聊适合的 API 方案吗?
这句话里包含不止一个值得识别的信号。它在咨询商业方案,也说明了实际用途、规模和时间。只给它打上“销售咨询”标签,会丢掉后面这些信息;直接归为“高优先级”,又把判断标准藏起来了。
更清楚的做法是分别问三个问题:咨询属于哪一类、是否提出了时间计划、接入计划有多具体。 分类用于分派,时间信号用于准备沟通,计划具体程度用于整理跟进顺序。每个答案都有自己的用途,不必把它们压成一个标签。
三种问题类型,分别解决什么问题?
| 类型 | 适合问什么 | 得到什么 |
|---|---|---|
choice | 这是方案咨询、技术接入问题,还是其他消息? | 一个选项及各选项的概率 |
noul | 消息是否提出了明确的上线时间? | 条件成立的概率,范围为 0–1 |
score | 这份接入计划有多具体? | 在自定义等级上的分数及概率分布 |
choice 用来选一个类别。若多个标签可以同时成立,例如“提到了时间”和“提出了试用需求”,应拆成两个 noul,而不是让它们争夺同一个分类结果。Choice 类型说明。
noul 的数值表示“是”的概率,不表示强弱程度。例如“是否提到了上线时间”适合用它;“计划有多成熟”则更适合用 score。Noul 类型说明。
score 要先定义有顺序的等级。三个等级对应 0、1、2,但结果不必是整数:它是按各等级概率计算的加权分数,而不是强制选出的档位。Score 类型说明。
把上下文和判断标准分开
JEV 请求里最重要的是 state 和 questions:前者放待判断的内容,后者定义要问什么、按什么标准判断。下面的请求让三个问题共同读取刚才那条咨询。
{
  "model": "jev-latest",
  "state": "我们准备在十月上线一个分析看板,需要每天跟踪三个市场的 500 个关键词。可以聊聊适合的 API 方案吗?",
  "questions": {
    "topic": {
      "type": "choice",
      "instructions": "这条消息主要属于哪类咨询?",
      "criteria": {
        "sales": "讨论 API 方案、采购或适合的用量套餐",
        "integration": "询问如何实现接入,或排查具体技术问题",
        "other": "不属于以上两类的消息"
      }
    },
    "has_timeline": {
      "type": "noul",
      "instructions": "消息是否明确提出上线或接入的时间?",
      "criteria": {
        "true": "给出月份、日期或明确的相对时间安排",
        "false": "没有给出时间,或只说以后可能考虑"
      }
    },
    "plan_readiness": {
      "type": "score",
      "instructions": "消息中的 API 接入计划有多具体?",
      "criteria": [
        "仅了解产品,没有描述具体使用场景",
        "说明了具体使用场景,但没有明确的时间和规模计划",
        "说明了具体使用场景,并给出了时间和规模计划"
      ]
    }
  }
}
在 Sukidata 中,将这个 JSON 发送到 POST https://api.sukidata.com/v1/systemone。完整的鉴权和请求示例见 JEV API 文档。
问题名称只是用于对应答案。实际需要模型理解的含义,应写进 instructions 和 criteria。同一次请求中的问题独立判断,不会自动读取其他问题的答案。
好的评分,先从好的量表开始
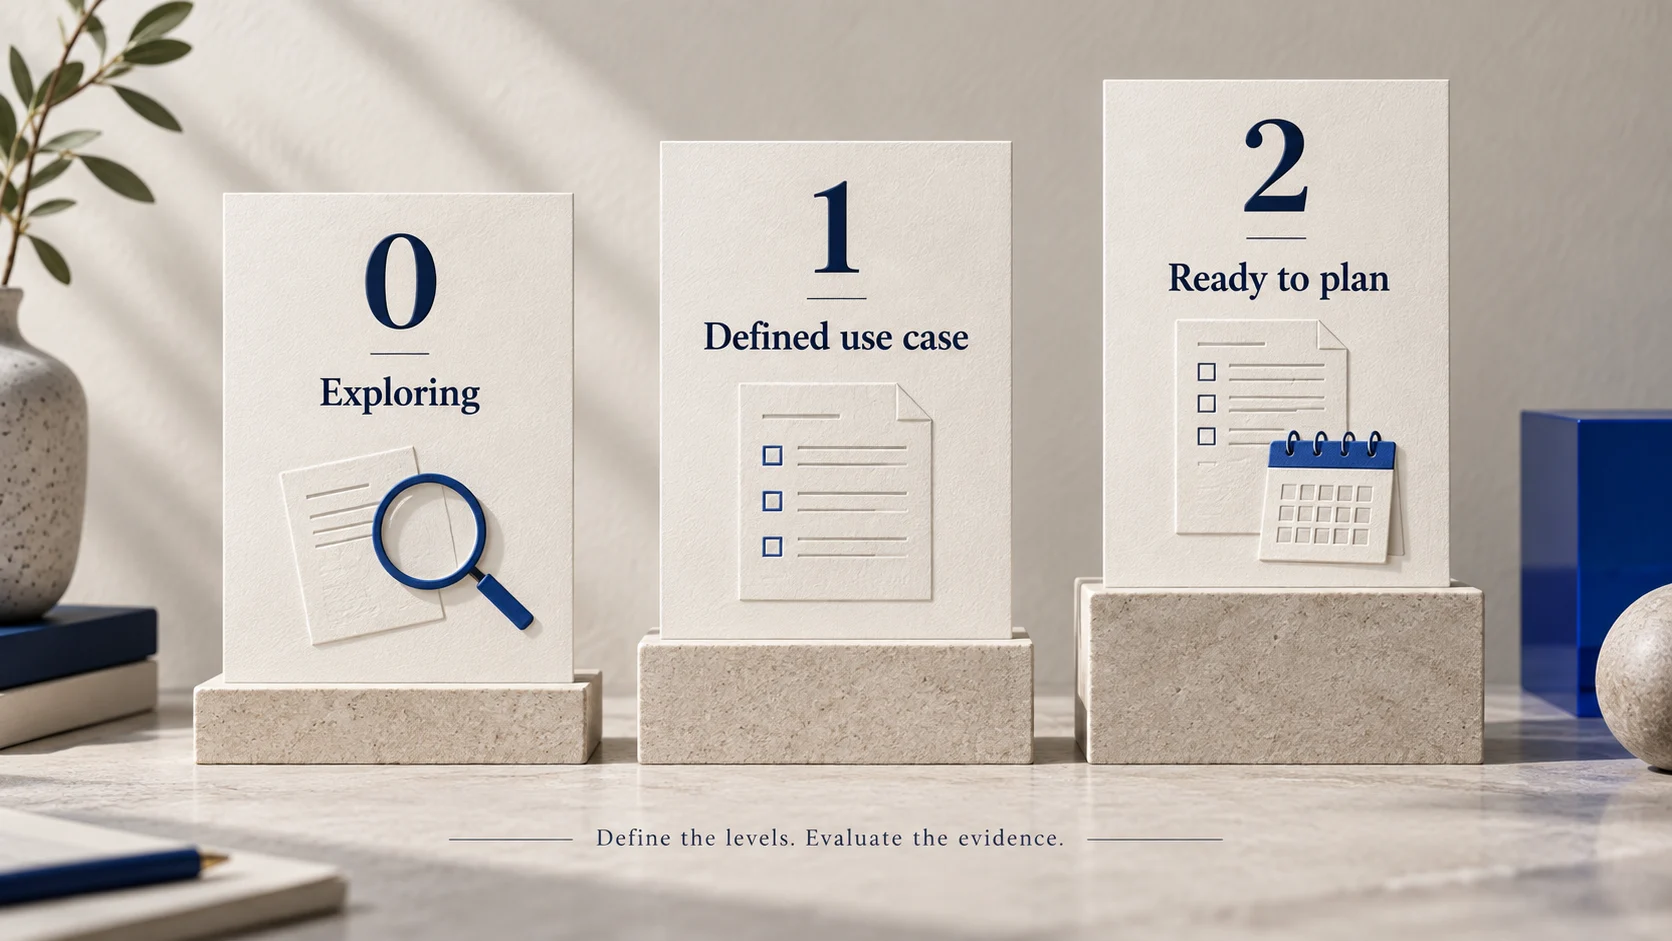
“低、中、高”看起来很简洁,但没有告诉模型应该看哪些证据。上面的量表把“计划具体程度”落到了可观察的信息上:有没有用途、时间和规模。
这也让你更容易检查结果。把输入换成“想了解一下你们的 API”,和“正在做一个关键词看板,但还没定上线时间”,就可以比较模型是否区分了不同阶段。图中只是等级示意,不是对任何客户的实际评分。
量表应围绕同一个维度。如果你还想评价商业价值,就单独增加一个问题;不要让“预算多”和“上线近”同时决定同一档分数,否则很难解释结果变化的原因。
读取答案,而不是再解析一段解释
响应的 answers 按问题名称返回结果。例如,可以读取 answers.topic.choice 获取类别,读取 answers.has_timeline.noul 获取时间条件成立的概率,读取 answers.plan_readiness.score 获取计划评分。
假设某次结果中,各评分等级的概率依次是 0.05、0.20、0.75,那么分数就是 0 × 0.05 + 1 × 0.20 + 2 × 0.75 = 1.7。这是帮助理解计算方式的示例,不是本文请求的实测响应。
Choice 和 Score 还会返回 confidence。它概括概率分布的集中程度,不等于所选项的概率,更不等于业务准确率。对于难以区分的咨询,可以先保留待确认,而不是只因系统返回了一个类别就立即执行后续操作。置信度说明。
除了咨询分派,还能用在哪里?
内容整理。 为知识库文章选择主题,再独立判断是否涉及某项功能。主题分类和功能标签可以分别维护,减少类别不断膨胀的问题。
搜索结果筛选。 将查询和候选内容一起放进上下文,按你定义的相关性等级逐条评价。它适合在已经取得候选结果后辅助排序,并不代替搜索本身。
智能体流程选择。 判断一条需求更适合查询文档、打开产品页面还是交给人工,再由程序执行对应步骤。模型负责理解请求,权限和具体操作仍由应用控制。
这些场景的共同点是:你知道可以返回哪些类型的答案,也知道每种答案接下来要用在哪里。如果任务本身是写报告、生成图片或完成长篇开放式分析,就应该选择对应的生成模型或工具。
在 Sukidata 中试一试
打开 JEV Playground,将自己的文本放进 State,再添加问题。先看预览中的类别、概率和评分,确认判断标准合适后,再导出 API 请求接入应用。
目前支持 jev-latest、jev-preview 和固定版本 jev-1.13.0。跟随正式版本可以使用 jev-latest;需要试用预览版本时选择 jev-preview;需要固定条件对比效果时使用版本号。
Sukidata 的 JEV 输入价格为 每百万 token $0.042,输出免费。费用按实际输入 token 计算,不按问题个数直接定价。模型与价格详情可查看 JEV 产品页。
最容易落地的起点,是挑选一个目前靠人工读文本再分类的环节,把分类标准写清楚,用一组有代表性的真实案例检查结果,再决定哪些判断值得自动化。