客服工单分流
识别客户留言的意图与主题,为客服系统提供分流依据;结果不明确的咨询仍可交给人工复核。
JEV API
识别客户意图、分派请求、评价内容相关性。通过 TypeSafe 的 System One 模型 JEV,把文本转为明确的分类、概率与评分,为应用和智能体的下一步提供依据。
我们计划下个月接入 API,每月预计调用 10 万次,想了解适合团队的方案。
认识 JEV
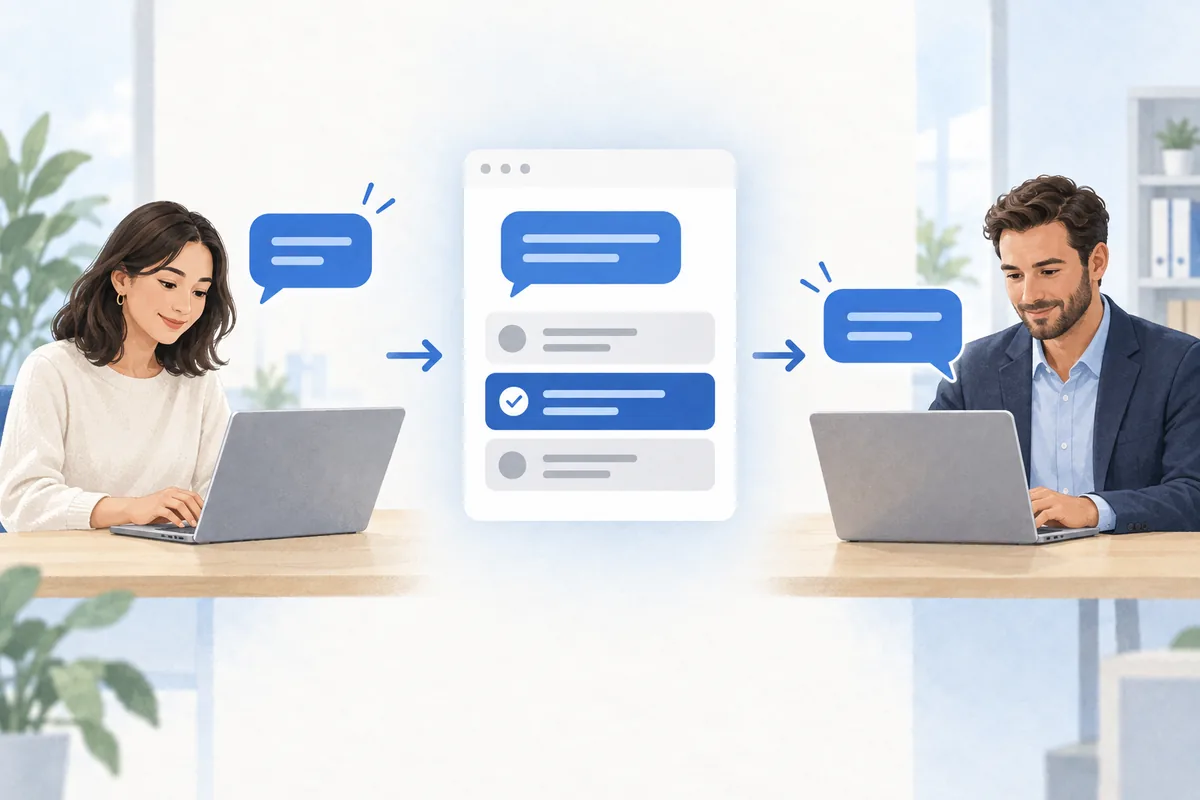
客户留言、商品介绍和文档片段,都包含软件需要理解的信息。JEV 是 TypeSafe 的 System One 模型,面向这类文本理解与判断任务:根据你提供的上下文和标准,给出类别、条件成立的概率或评分。
它适合嵌入已有流程中需要“看懂内容再做选择”的一步。语言模型可以负责撰写回复或总结,JEV 则可以用于选择处理路径、挑选相关资料、检查回复是否满足要求,再由应用根据判断结果安排后续操作。
应用场景
适合需要反复阅读内容、按标准判断,再决定如何处理的业务环节。
识别客户留言的意图与主题,为客服系统提供分流依据;结果不明确的咨询仍可交给人工复核。
根据用户的问题,对检索到的段落进行相关性评分,用于候选结果排序,为回答挑选更有用的上下文。
判断请求所属领域与复杂程度,让应用选择合适的专业智能体、语言模型、简单规则或人工处理。
检查回答是否切题、是否遵循业务规则、是否有上下文依据,将可疑结果标记出来,交给后续复核。
按你的标准评价企业匹配度与购买意向,为新线索安排优先级,找出值得进一步跟进的客户咨询。
按主题和情绪整理评论、问卷与客服对话,将开放式反馈转为可追踪的分类,帮助团队发现反复出现的问题。
用于你的业务
想知道某个条件是否成立,例如“客户是否在咨询价格”,可以用 noul 获取条件成立的概率。需要从几个类别中选择处理方向,例如将咨询分给销售、技术支持或账号管理,则适合使用 choice。
如果标准有高低顺序,可以用 score,例如区分一段资料是“仅提到主题”“回答了部分问题”,还是“直接回答了问题”。分数可以落在等级之间,反映各档标准的概率分布。通过这三种问题类型,应用可以直接取得所需的判断,而不必再从一段文字回复里提取结论。
查看客户咨询分流示例先确定分类之后要做什么。处理客户咨询时,可以将类别设为方案选择、接入指导和账号管理,说明每个类别包含哪些情况,并提供客户留言与必要的产品背景,让判断有据可依。
一条消息往往不只有一个有用的信息点。你可以针对同一份上下文,分别判断咨询主题、购买意向和时间要求,再由应用组合这些答案,决定处理团队与跟进顺序。
评分标准应描述可观察的差异。评价搜索相关性时,可以区分“仅提到相关主题”“回答了部分问题”和“直接回答了问题”。这样的标准比单纯的“低、中、高”更容易用于结果排序。
不同目标适合分开评价。一段资料可能相关但不完整,一个销售线索可能符合目标客户特征,却还没有明确的采购时间。分别评价后,再按业务需要组合分值、筛选或排序。
有些消息同时接近两个类别,有些记录缺少必要信息。通过结果的概率分布,可以发现这类不明确的情况,让流程转向补充信息、增加一次检查或交由人工复核。
开启自动处理前,先选取自己业务中的代表性案例和边界情况测试,对照团队的判断调整标准与阈值。置信度可以帮助决定处理方式,但不保证答案正确。
从试用到接入
先确认判断效果,再把它放进应用或智能体。
输入真实案例,定义分类或评分标准,检查常见与模糊情况的结果,并导出可用的请求。
将分类与评分接入现有的客服、搜索或业务流程,由应用决定自动处理、人工复核或后续操作。
让支持 MCP 的智能体评价候选内容、选择处理路径或检查回答,在执行操作前多一步判断。
按用量计费
按输入用量计费,输出免费。适合从小规模验证开始,逐步用于日常分类、筛选与评分。
JEV 是 TypeSafe 面向 AI 判断的 System One 模型。它根据文本或结构化上下文给出分类、概率和评分,供软件进行分流、筛选与优先级排序。Sukidata 提供 API、Playground 和 MCP 接入方式。
当下一步需要做出判断时,例如选择处理团队、评价相关性或检查某个条件,可以使用 JEV。开放式写作与对话则可以交给语言模型。例如,先用 JEV 分流客服请求,再由语言模型起草回复。
可以。你可以按业务需要定义判断条件、分类选项和有序评分等级,也可以在一次请求中评价同一份上下文的多个方面,例如留言主题、购买意向与紧急程度。
先用业务中的代表性案例测试,再设置自动处理或复核的阈值。概率与置信度可以帮助识别不确定的结果,但不保证判断正确。涉及重要后果的决定应保留人工复核。
在 JEV Playground 中放入真实留言、文档片段或结构化记录,定义需要判断的问题并查看答案。确认效果后导出请求,接入应用;智能体也可以通过 MCP 使用 JEV。